25 sep 2026
Zo laat je een AI-project in de fabriek slagen: begin bij de data
AI-projecten die na de demo blijven draaien hebben één ding gemeen: context onder de data. Van alle data die fabrieken verzamelen wordt maar 43% gebruikt.
Wat de projecten die blijven draaien gemeen hebben
Natuurlijk wil je graag dat je eerste AI-project drie maanden na de demo nog draait, en antwoord geeft op vragen die in het ochtendoverleg echt gesteld worden. Dat kan op de data uit de machines die je nu hebt. De fabrieken waar het lukt hebben geen beter model. Ze hebben betere data onder het model.
Het verschil wordt pas zichtbaar na de demo. Een proof of concept draait op data uit een spreadsheet die iemand met de hand heeft geëxporteerd: keurige tijdstempels, één machine, een kolom met het ordernummer erbij. Dan moet het model aan de slag met live data. Het project dat op dat moment overleeft, is het project waar die orderkolom ook buiten de export bestaat, waar stopredenen op elke lijn op dezelfde manier worden vastgelegd, en waar de onderhoudshistorie een machinenummer heeft dat klopt met de PLC.
Niets daarvan is AI-werk. Het is datawerk, en daar kun je deze maand nog mee beginnen.
Een onderzoek laat zien hoeveel ruimte er is
Het 2026 State of Smart Manufacturing-rapport van Rockwell Automation vroeg ruim 1.500 productiebedrijven in 17 landen wat er in hun fabriek écht gebeurt. Eén uitkomst: van alle data die deze bedrijven verzamelen, wordt maar 43% goed gebruikt. De andere 57% wordt al aangemaakt en opgeslagen. Die ligt klaar om gebruikt te worden.
Het tweede getal is het hoopvolle. Op de vraag wat de groei intern het meest afremt, noemde 38% het vastleggen, begrijpen en gebruiken van data. Budget stond pas daarna, met 36%, volgens een analyse van het rapport. Die volgorde is nieuw en zegt iets: de grootste hefboom is niet langer wat je kunt betalen, maar wat je van je eigen productie te weten komt. En die hefboom staat al in je eigen pand.
Ondertussen draait een derde van de fabrieken (34%) al ergens AI in het proces, en verwacht het rapport dat dat in 2030 meer dan de helft is. De fabrieken die hun data nu op orde brengen, zijn straks de fabrieken waar dat vanzelf gaat.
Zo ziet bruikbare data er bij jou op de vloer uit
"Bruikbare data" klinkt abstract, tot je naast de lijn staat. In de praktijk kan een model met je data werken als dit klopt:
- Elke stop wordt gelogd met begintijd en duur, in plaats van een PLC-teller die om middernacht op nul springt. Je weet niet alleen dat gisteren een slechte dag was, je kunt ook zeggen welke stop het meeste heeft gekost.
- Tags hebben namen die een operator herkent. "Invoerband, draait" in plaats van
DB12.DBW4, zodat het model en de planner die in maart is begonnen hetzelfde lezen als je ervaren operator. - Stilstandredenen komen uit de machine of uit een vaste lijst op het moment van de stop, niet na de dienst uit het hoofd als "storing", "invoer weer", "zelfde als dinsdag".
- Keuringsresultaten worden bewaard, niet alleen getoond op een scherm bij het controlepunt.
- Het ordernummer uit het ERP, de batch van het etiket en de machinedata uit de PLC zijn aan elkaar gekoppeld, zodat je niet meer afhankelijk bent van iemand die er toevallig bij stond.
- Er is één definitie van "draaien", zodat dezelfde dienst één OEE-cijfer oplevert en het ochtendoverleg begint met dat cijfer in plaats van met een discussie erover.
Het rapport zegt hetzelfde in onderzoekstaal: gekoppelde data met context bouwt vertrouwen, en vertrouwen is wat informatie omzet in een besluit. Dat is een nette omschrijving van twee mensen die met hetzelfde cijfer een vergadering binnenlopen.
In de context zit de winst
Een waarde die uit een machine komt, is nog geen informatie. "21,4" is een getal.
"Extruder 2, zone 3, 21,4 bar, 14:07, order 88213, batch F-2207, veertig minuten na de omstelling naar de dunnere folie": dat is informatie. Alles na die 21,4 is context, en context is wat een model bruikbaar maakt.
Dit is het deel dat niemand in een demo laat zien, want het is saai: afspreken hoe dingen heten, machine-events koppelen aan orders en batches, één keer vastleggen wat een stop is en wat een omstelling. Doe je dat goed, dan is elke volgende vraag goedkoop, want de koppeling ligt er al. Dat is de echte opbrengst van het werk: niet één AI-project, maar elke vraag daarna.
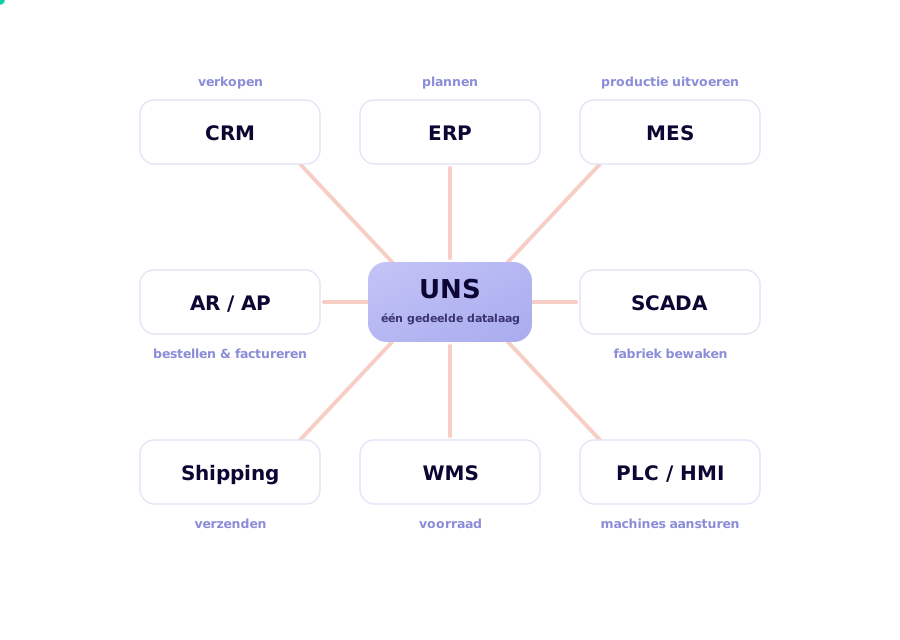
Die gedeelde laag heeft in ons vak een naam, de unified namespace. We leggen hem apart uit in wat een unified namespace is en waarom AI er een nodig heeft. Wat hij je oplevert is eenvoudiger dan de naam doet vermoeden: één plek waar een machine-event al weet bij welke lijn, order, batch, product en dienst het hoort. MeshOS is hoe wij die laag bouwen, en de koppelingen zijn read-only, tenzij aansturen nu juist het doel van het project is.
Een cijfer dat je kunt narekenen, wordt gebruikt
Hetzelfde rapport vond dat 93% van de productiebedrijven verwacht dat de samenstelling van hun personeel blijvend verandert door smart manufacturing, en dat 40% het afgelopen jaar een deel van de mensen heeft bijgeschoold. Opleiden helpt. Wat het laat beklijven is een dashboard dat de ploeg gelooft.
Een operator gelooft een dashboard als het klopt met zijn dag: als het 94% beschikbaarheid meldt en hij kan doorklikken naar de twee uur die hij kwijt was aan een vastgelopen invoer, netjes als stop met tijdstip en reden. Elk cijfer moet dus terug te herleiden zijn naar de gebeurtenissen eronder: deze OEE, deze stops, deze tijdstippen, hier is die ontbrekende 6% gebleven. Een live OEE-dashboard verdient zijn plek als je vanaf het percentage kunt doorklikken naar die ene stop om 03:12, en automatische stilstandregistratie is wat dat doorklikken mogelijk maakt.
Bij een verpakkingsproducent waar we mee werken komt elke stop automatisch uit de PLC en krijgt hij meteen een categorie: omstelling, storing, aanvoertekort, microstop. De winst zit niet in de Pareto. De winst is dat er niet meer over gediscussieerd wordt, zodat het overleg gaat over het oplossen van de grootste stop.
Het plan: één machine, daarna één lijn
- Kies de machine die pijn doet. Niet de nieuwste. Die ene die in elk dienstrapport terugkomt.
- Lees hem uit zoals hij staat. Een edge computer naast de kast, read-only, op de PLC's en sensoren die er al zijn. Er wordt geen machine vervangen en geen regel besturingslogica aangepast.
- Spreek de namen één keer af. Een taglijst die een operator herkent. "Invoerband, draait" in plaats van
DB12.DBW4, één keer vastgelegd en daarna overal zo gebruikt. - Voeg de context toe die je al hebt. Ordernummer, batch, product, dienst. Het meeste bestaat al, het zit alleen in een ander systeem.
- Stel dan pas je eerste AI-vraag. Dat is op dat moment een kleine vraag, en het antwoord kun je zelf narekenen.
Twee tot vier weken per machine is een realistisch tempo. Stap twee en drie doen wij gratis op één machine, read-only, want naar je eigen data kijken levert meer op dan discussiëren over wat die waard is: verbind één machine.
Eerlijk over wat een datalaag niet doet
- Hij levert geen businesscase op. Netjes geordende data waar niemand iets mee doet is hetzelfde probleem in een duurdere jas. Bepaal welk besluit de data moet veranderen voordat je iets koppelt.
- Oude besturingen hebben een plafond. Een PLC uit de jaren negentig geeft soms alleen draaien, gestopt en een storingscode. Wil je daar detail per cyclus, dan moet er een sensor bij, en dat is montagewerk met stilstand, geen software-aanpassing.
- Niet elke vraag heeft AI nodig. Een grenswaarde met een alarm lost op de vloer meer op dan een model, en is een stuk makkelijker uit te leggen als een auditor vraagt waar het cijfer vandaan komt.
- Dit onderzoek gaat niet over jouw fabriek. Meer dan de helft van de deelnemers zijn bedrijven met een omzet boven een miljard dollar. De richting klopt, de benchmarks zijn niet de jouwe. Een fabriek met zestig man en vier lijnen begint ergens anders, en meestal makkelijker.
Wil je het langere verhaal, inclusief waar industriële AI zich wel en niet terugverdient, dan staat dat in onze whitepaper over industriële AI.
Veelgestelde vragen over AI op de werkvloer
Hebben we een unified namespace nodig voordat we met AI kunnen beginnen?
Nee. Je hebt context nodig, en een unified namespace is één manier om die te ordenen. Eén machine met nette namen, gekoppeld aan orders en batches, is genoeg om een echte vraag te beantwoorden. Bouw de gedeelde laag als de tweede en derde lijn erbij komen, niet als voorwaarde voor de eerste.
Hoeveel data hebben we nodig?
Dat hangt van de vraag af, en het eerlijke antwoord is meestal: minder volume, meer context. Anomaliedetectie op trillingen kan na een paar weken meten al beginnen. Een model dat een specifieke storing voorspelt, heeft voorbeelden van die storing nodig, en dat kan een jaar historie of meer zijn. Een model dat afkeur voorspelt, heeft gelabelde afkeur nodig: kwaliteitsoordelen moeten dus worden vastgelegd, niet alleen getoond bij het controlepunt.
Onze machines zijn oud. Zijn die überhaupt aan te sluiten?
Meestal wel. Siemens S7-300's, Modbus-apparaten, potentiaalvrije contacten en bijgeplaatste sensoren werken allemaal, en de machine draait gewoon door terwijl we ermee bezig zijn. De grens is wat de besturing naar buiten brengt. Een oudere machine geeft je misschien alleen draaien, gestopt en een storingscode. Voor beschikbaarheid en stopanalyse is dat genoeg. Voor een kwaliteitsmodel niet.
Kunnen we de data in ons eigen pand houden?
Ja. MeshOS draait self-hosted op je eigen infrastructuur of in de cloud, en in beide gevallen is de data van jou. Voor fabrieken met automotive klanten, of met een IT-afdeling die NIS2 op het bureau heeft liggen, is self-hosted meestal het kortste gesprek.
Conclusie: het project dat slaagt, begint met meten wat je hebt
De ruimte die dit onderzoek meet, zit niet in ambitie. Fabrieken verzamelen al data genoeg; 57% ervan ligt klaar om gebruikt te worden. Daarom beginnen de projecten die slagen met het saaie, goedkope deel: tags fatsoenlijk benoemen, machine-events koppelen aan orders en batches, elk cijfer narekenbaar maken, en dan pas een vraag stellen die een model waard is. Heb je dat op orde, dan is de AI het makkelijke deel.
Begin met één machine en één vraag waar je nu elke week over discussieert. Zodra het antwoord overeind blijft in het ochtendoverleg, kost de tweede machine dagen in plaats van maanden.
Benieuwd wat je eigen lijn oplevert? Verbind één machine met ons, of lees hoe MeshOS je productiedata in één laag samenbrengt.